Was Datenextraktion leistet – und was dabei offenbleibt
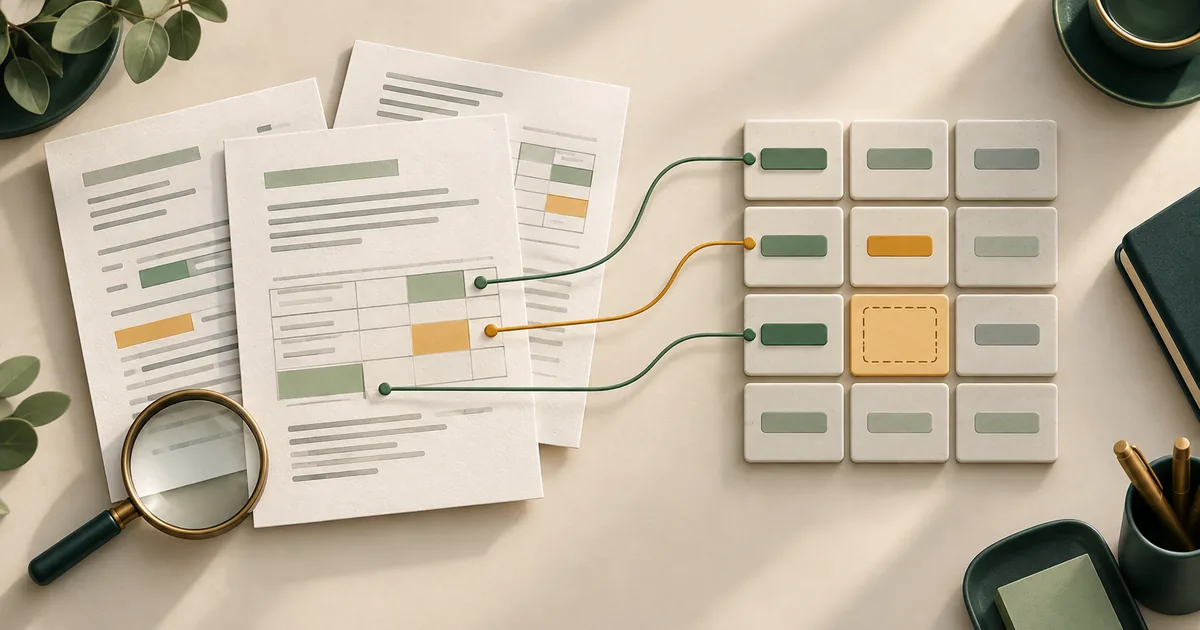
Bei der Datenextraktion werden einzelne Angaben aus einem Dokument festen Feldern zugeordnet: etwa Bestellnummer, Artikel, Menge, Einheit und gewünschter Liefertermin. Das Ergebnis ist ein Datensatz, den eine Tabelle oder eine Fachanwendung weiterverarbeiten kann. Eine Zusammenfassung verfolgt ein anderes Ziel. Sie verdichtet den Inhalt, lässt aber möglicherweise genau die Einzelheit weg, die für den nächsten Arbeitsschritt nötig ist.
Auch die Suche in einer Dokumentensammlung ist eine andere Aufgabe. Der Beitrag zu RAG mit eigenen Dokumenten behandelt Antworten auf Fragen an einen Wissensbestand. Hier geht es um die wiederholbare Erfassung bestimmter Felder aus eingehenden Belegen. Beide Verfahren können zusammenarbeiten, brauchen aber unterschiedliche Abnahmekriterien.
Eine wichtige Grenze: Ein korrekt gelesener Wert ist noch keine bestätigte Geschäftsinformation. Steht in einer Bestellung eine falsche Artikelnummer, darf die Extraktion diese nicht stillschweigend durch eine vermeintlich passendere ersetzen. Sie soll die Angabe erfassen und den Widerspruch für die Prüfung sichtbar machen.
Erst prüfen, ob strukturierte Daten bereits vorhanden sind
Bevor Sie PDFs mit KI auslesen lassen, lohnt sich ein Blick auf den Eingangskanal. Kann der Geschäftspartner dieselben Angaben als strukturierten Export liefern? Gibt es eine vorhandene Schnittstelle, einen Formularimport oder einen maschinenlesbaren Bestandteil des Belegs? Solche Daten lassen sich häufig direkter übernehmen als Informationen, die erst aus einem Seitenlayout rekonstruiert werden müssen.
Das bedeutet nicht, jede Zusammenarbeit auf ein neues Format umzustellen. Für einen großen, regelmäßig liefernden Partner kann ein vereinbarter Datenaustausch sinnvoll sein. Für gelegentliche Bestellungen in wechselnden PDF-Layouts bleibt Dokumentverarbeitung eine mögliche Ergänzung. Der geplante Ablauf sollte beide Eingänge unterscheiden, statt strukturierte Daten zuerst in Bilder und anschließend wieder in Felder zu verwandeln.
Wenn nur wenige Belege pro Monat anfallen, kann eine gute Erfassungsmaske mit Pflichtfeldern bereits genügen. Die Entscheidung hängt vom tatsächlichen Erfassungsaufwand, von den Fehlerfolgen und von der Vielfalt der Dokumente ab. Eine beeindruckende Demo allein beantwortet diese Fragen nicht.
OCR, Dokumentmodelle und Sprachmodelle auseinanderhalten
OCR steht für optische Zeichenerkennung. Sie macht Schrift in einem Scan oder Foto als Text zugänglich. Bei einem digital erzeugten PDF kann dagegen bereits eine Textschicht vorhanden sein. Trotzdem muss die Anwendung erkennen, welche Zahl zu welcher Zeile, Spalte oder Überschrift gehört. Ein lesbarer Textstrom erhält diese Zuordnung nicht automatisch.
Microsoft beschreibt für Azure Document Intelligence getrennte Funktionen für Texterkennung, Layoutanalyse und vorbereitete beziehungsweise eigene Extraktionsmodelle. Die Layoutanalyse erfasst unter anderem Tabellen und Dokumentstruktur; vorbereitete Modelle adressieren bestimmte Dokumentarten. Das sind Herstellerangaben zum Funktionsumfang, keine Aussage zur erreichbaren Qualität mit Ihren Belegen.
Ein Sprachmodell kann zusätzlich helfen, unterschiedlich formulierte Angaben einem Feld zuzuordnen. Dafür braucht es klare Regeln: nur belegte Werte übernehmen, Mehrdeutigkeiten kennzeichnen und fehlende Angaben nicht ergänzen. Ob diese Regeln tatsächlich eingehalten werden, muss die Anwendung prüfen. Ein formal gültiges Ausgabeformat sagt noch nichts darüber aus, ob die Menge aus der richtigen Tabellenzeile stammt.
Die Feldliste ist der wichtigste Teil des Auftrags
„Lies die Bestellung aus“ ist für einen betrieblichen Ablauf zu ungenau. Definieren Sie vor dem ersten Versuch, welche Felder benötigt werden und was sie bedeuten. „Datum“ könnte das Bestelldatum, das Versanddatum oder der gewünschte Liefertermin sein. „Betrag“ könnte einen Einzelpreis oder die Gesamtsumme bezeichnen. Solche Unklarheiten kann ein Modell plausibel auflösen und dabei trotzdem die falsche Entscheidung treffen.
Zu jedem Feld gehören die erlaubte Form, die Quelle und die Behandlung von Ausnahmen. Eine Artikelnummer bleibt beispielsweise Text, damit führende Nullen erhalten bleiben. Eine Menge braucht eine Einheit. Ein Datum wird nur dann in ein einheitliches Format umgewandelt, wenn seine Bedeutung eindeutig ist. Der gelesene Originalwert bleibt daneben verfügbar.
- Pflichtangabe: Ohne diese Information darf der Datensatz nicht weitergegeben werden.
- Optionale Angabe: Das Feld darf leer bleiben, wenn der Beleg keinen Wert enthält.
- Mehrdeutige Angabe: Mehrere mögliche Werte werden zur Entscheidung vorgelegt.
- Abgeleitete Angabe: Eine Berechnung oder Stammdatenzuordnung wird getrennt vom gelesenen Wert gespeichert.
Diese Trennung verhindert, dass eine Vermutung später wie eine Aussage des Geschäftspartners aussieht. Sie macht auch die Übergabe an einen technischen Umsetzungspartner konkreter: Die Feldliste beschreibt, was die Lösung liefern soll und wann sie anhalten muss.
Ein Musterfall: Eine Bestellung mit unklarem Liefertermin
Das folgende Beispiel ist fiktiv und beschreibt kein Kundenprojekt. Eine Bestellung enthält die Nummer B-1042, zwölf Stück des Artikels 0047 und den Hinweis „Lieferung möglichst Anfang Oktober“. Auf der zweiten Seite stehen weitere Positionen. Im Begleittext der E-Mail wird um Rückmeldung zum Termin gebeten.
Ein brauchbarer Datensatz übernimmt die Bestellnummer und erhält die führenden Nullen der Artikelnummer. Menge und Einheit werden getrennt erfasst. Beim gewünschten Liefertermin bleibt die ursprüngliche Formulierung sichtbar; ein konkretes Tagesdatum wird nicht erfunden. Der Status lautet beispielsweise „Termin klären“. Auch eine Zusammenfassung darf daraus keine verbindliche Lieferung am 1. Oktober machen.
Für jede Position wird die Fundstelle mitgeführt: Dateiname, Seite und möglichst der markierte Ausschnitt. Bei widersprüchlichen Angaben zwischen E-Mail und Anhang braucht es eine vorab vereinbarte Regel oder eine Rückfrage. Das Modell soll nicht eigenständig entscheiden, welche Nachricht verbindlich ist. Die zuständige Person sieht den Konflikt neben dem Original und dokumentiert ihre Entscheidung.
Erst danach entsteht ein Entwurf im Zielsystem. Eine automatische Auftragsbestätigung oder Bestellung beim Lieferanten ist ein weiterer Prozessschritt mit eigenen Freigaben. Dass die Erfassung funktioniert, ist noch kein Grund, diese Folgeaktionen ebenfalls zu automatisieren.
Die Prüfung braucht mehr als einen Konfidenzwert
Einige Dokumentdienste liefern Konfidenzwerte, also Einschätzungen zur Sicherheit einer Erkennung. Microsoft unterscheidet dabei verschiedene Ebenen, etwa Wörter und Felder. Nicht jedes Feld liefert einen solchen Wert. Ein Konfidenzwert kann helfen, eine Prüfliste zu sortieren; er bestätigt weder die sachliche Richtigkeit der Bestellung noch die Gültigkeit einer Geschäftsregel.
AWS empfiehlt für Amazon Textract, Schwellenwerte an der Fehlerempfindlichkeit des Anwendungsfalls auszurichten und unsichere Ergebnisse gegebenenfalls menschlich prüfen zu lassen. Einen universellen Grenzwert für alle Dokumente daraus abzuleiten wäre unpassend. Ebenso wenig sollte eine vom Sprachmodell frei formulierte Angabe wie „sehr sicher“ als Ersatz für einen gemessenen Qualitätsnachweis dienen.
Zusätzlich braucht es einfache, nachvollziehbare Regeln: Ist die Artikelnummer im Stamm vorhanden? Passt die Einheit zum Artikel? Stimmen Positionszahl und erfasste Zeilen überein? Stimmen berechnete Summen innerhalb der vereinbarten Rundungsregeln? Solche Prüfungen erledigt möglichst eine deterministische Programmlogik. Ein rechnerisch stimmiger Datensatz kann trotzdem falsch zugeordnet sein; deshalb bleiben Belegstelle und fachliche Kontrolle wichtig.
Schwierige Belege gehören von Anfang an in den Test
Ein Test mit fünf sauberen PDFs desselben Absenders zeigt wenig über den späteren Alltag. Nehmen Sie auch mehrseitige Tabellen, schlechte Scans, abweichende Schreibweisen, leere Pflichtfelder und mehrere Mengen- oder Datumsangaben auf. AWS weist bei Textract ausdrücklich auf mögliche Probleme mit verbundenen oder uneinheitlichen Tabellenzellen hin. Das ist ein guter Anlass, genau solche Belege früh auszuprobieren.
Für den Vergleich wird eine fachlich geprüfte Soll-Erfassung angelegt. Messen Sie nicht nur, wie viele Zeichen erkannt wurden. Entscheidend ist, wie viele relevante Felder richtig zugeordnet sind, wie viele vollständige Belege ohne Korrektur verwendbar sind und welche Fehler unbemerkt durch die Kontrollen gehen. Eine falsche Lieferadresse wiegt anders als eine übersehene optionale Notiz.
Halten Sie einen Teil der Dokumente für die abschließende Prüfung zurück. Werden alle Beispiele ständig zur Anpassung verwendet, bleibt unklar, wie gut die Lösung mit neuen Belegen zurechtkommt. Die notwendige Testmenge hängt von Varianten und Fehlerfolgen ab; eine feste kleine Anzahl ist kein Qualitätsversprechen. Bei seltenen, kritischen Sonderfällen ist eine manuelle Bearbeitung oft die vernünftigere Grenze.
Nacharbeit und Rückfragen entscheiden über den Nutzen
Für einen ersten Vergleich zählt die gesamte Bearbeitungszeit: Eingang öffnen, Angaben erfassen, prüfen, korrigieren und übergeben. Dem wird derselbe Ablauf mit automatischer Vorbefüllung gegenübergestellt. Wenn das Team die KI-Ausgabe mühsam mit dem Original vergleichen muss, kann die Erkennung schnell sein und der Gesamtprozess trotzdem kaum gewinnen.
Eine hilfreiche Prüfansicht zeigt deshalb Original und Felder nebeneinander, springt zur Fundstelle und hebt ungeklärte Angaben hervor. Wer einen Wert korrigiert, sollte den Grund knapp festhalten können. Daraus lässt sich erkennen, ob immer dieselbe Spalte verrutscht, ein Dokumenttyp ungeeignet ist oder die eigene Felddefinition überarbeitet werden muss.
Zu den Kosten gehören neben Modell- und Dokumentverarbeitung auch Einrichtung, Schnittstellen, laufende Betreuung und menschliche Nacharbeit. Vergleichen Sie den Aufwand pro verwendbarem Beleg. Für kleine Mengen ist die wartbare Lösung häufig wichtiger als die höchste automatische Verarbeitungsquote.
Eine sichere Übergabe hält Original und Bearbeitungsstand zusammen
Jeder Eingang braucht eine eindeutige Kennung. Wird ein Anhang erneut gesendet oder die Verarbeitung nach einer Unterbrechung wiederholt, darf daraus nicht unbemerkt ein zweiter Auftrag entstehen. Dafür müssen Dokumenterkennung und Zielsystem zusammenarbeiten. Ein Dateiname allein ist als Identität meist zu schwach; umbenannte Anhänge und korrigierte Fassungen gehören ausdrücklich in die Anforderungen.
Speichern Sie nachvollziehbar, welcher Originalbeleg zu welcher Ausgabe und zu welcher Korrektur gehört. Unterscheiden Sie „erfasst“, „Prüfung offen“, „freigegeben“ und „übergeben“. Wenn das Zielsystem vorübergehend nicht erreichbar ist, bleibt die Übergabe offen. Ein technischer Wiederholungsversuch darf keinen bereits übernommenen Datensatz verdoppeln.
Auch die Eingabedatei selbst ist eine fremde Quelle. Anweisungen innerhalb eines Dokuments dürfen keine Systemregeln überschreiben oder zusätzliche Aktionen auslösen. Die Extraktion benötigt nur die vorgesehenen Leserechte und Ausgabewege. Dokumente und Prüfausgaben gehören außerdem in ein für diese Daten freigegebenes Unternehmens-Setup; Anbieter, Zugriffe und Aufbewahrung sind vor dem Test zu klären. Der Artikel zu KI-Datenschutz in Unternehmen erläutert die dafür relevanten Unterschiede.
Was Sie für ein erstes Gespräch vorbereiten können
Wählen Sie einen Dokumenttyp und einen konkreten Folgeschritt, etwa Bestellungen als geprüfte Entwürfe in einer Auftragsverwaltung. Notieren Sie die benötigten Felder, die ungefähre monatliche Menge und den heutigen Bearbeitungsweg. Ergänzen Sie typische Ausnahmen und die Information, wer bei unklaren Angaben entscheidet. Für die erste Einordnung genügen anonymisierte Muster; vertrauliche Originale sollten erst über einen vereinbarten geeigneten Weg geteilt werden.
Jacob Damböck unterstützt mit der KI-Potenzialanalyse und der Planung von Prozessautomatisierung dabei, Anforderungen, Kontrollen und einen begrenzten Einstieg zu klären. Das erste Ergebnis sollte eine belastbare Entscheidung sein: Welche Angaben lassen sich sinnvoll vorerfassen, welche Prüfung bleibt erforderlich und wann ist ein vorhandener Import die einfachere Lösung?
Primärquellen und Einordnung
Die verlinkten Dokumentationen von Microsoft und Amazon Web Services wurden am 23. September 2026 geprüft. Sie belegen die genannten Produktfunktionen und Hinweise zu Erkennungsqualität und Konfidenzwerten. Funktionsumfang und verfügbare Modelle können sich ändern.
Feldregeln, Musterfall, Prüfansicht und Übergabeempfehlungen sind die redaktionelle Einordnung von Jacob Damböck. Sie sind keine gemessenen Kundenergebnisse und keine allgemeingültige Produktbewertung. Ob sich der Ablauf lohnt, lässt sich erst mit den tatsächlich anfallenden Dokumenten und dem zugehörigen Prüfaufwand beurteilen.